Wenn du Keycloak produktiv betreibst, hängt an der Datenbank mehr, als man auf den ersten Blick denkt: Sessions, Realms, Clients, Credentials – fällt die Datenbank aus, steht auch Keycloak. Und ohne Keycloak können sich Nutzer:innen bei keiner angebundenen Anwendung mehr anmelden. Genau deshalb lohnt es sich, PostgreSQL für Keycloak nicht als Single Point of Failure stehen zu lassen, sondern mit einer Hochverfügbarkeitslösung (HA) abzusichern.
In diesem Artikel zeige ich dir, wie du das mit pg_auto_failover umsetzt – einer schlanken, leicht zu betreibenden Failover-Lösung für PostgreSQL.
Warum pg_auto_failover?
Es gibt mehrere Wege, PostgreSQL hochverfügbar zu machen – etwa Patroni (in Kombination mit etcd/Consul als Konsens-Store), repmgr oder verwaltete Cloud-Lösungen. Diese Tools unterscheiden sich vor allem im Funktionsumfang und in der Betriebskomplexität.
pg_auto_failover sticht dabei durch eines heraus: Es ist eine leichtgewichtige Lösung. Es kommt ohne externen Konsens-Store aus, besteht im Kern aus einem Monitor-Prozess und den pg_autoctl-Agents auf den Datenbank-Knoten, und lässt sich mit überschaubarem Aufwand aufsetzen und verstehen.
Wichtig zum Verständnis: pg_auto_failover erfindet keine eigene Replikation. Die eigentliche Datenübertragung zwischen Primary und Secondary läuft über die ganz normale, native Streaming-Replikation von PostgreSQL – dieselbe Technik, die es in PostgreSQL schon lange gibt, unabhängig von pg_auto_failover. Was pg_auto_failover hinzufügt, ist die Orchestrierung drumherum: Auf jedem Node läuft ein sogenannter Keeper-Prozess (das ist im Kern der pg_autoctl-Agent), der die lokale PostgreSQL-Instanz über die Standard-Bordmittel steuert – also z. B. über pg_ctl und ganz normale SQL-Befehle – und sich laufend mit dem Monitor abstimmt. Der Keeper beobachtet dabei unter anderem den Replikations-Rückstand (WAL-Delta) über die eingebauten PostgreSQL-Statistik-Views, und der Monitor entscheidet auf dieser Basis, ob ein Failover sinnvoll und sicher ist.
Auch bei der Wiederherstellung greift pg_auto_failover auf PostgreSQL-Bordmittel zurück: Ein Node, der zu weit zurückgefallen ist, wird per pg_basebackup neu synchronisiert; ein Node, dessen Historie vom neuen Primary abweicht (z. B. nach einem Split-Brain-artigen Szenario), wird per pg_rewind wieder angeglichen. pg_auto_failover ist also im Kern eine Steuerungs- und Automatisierungsschicht über bewährte, native PostgreSQL-Mechanismen – kein Ersatz dafür.
Das heißt nicht, dass es für jeden Anwendungsfall die richtige Wahl ist – Patroni etwa bietet mehr Flexibilität bei komplexeren Topologien und wird in großen, dynamischen Umgebungen häufig bevorzugt. Am Ende solltest du immer schauen, welche Lösung zu deinen Anforderungen (Team-Know-how, Betriebsumgebung, Skalierung) passt. Für die meisten Keycloak-Setups – ein Primary, ein Secondary, ein überschaubares Netzwerk – deckt pg_auto_failover den Bedarf aber gut ab und ist dabei spürbar einfacher umzusetzen als die Alternativen.
| Versionshinweis: Dieser Artikel bezieht sich auf pg_auto_failover 2.2, Keycloak 26.7.2 und wurde auf Hosts mit Ubuntu 26.04 umgesetzt. Bei anderen Versionen können einzelne Schritte abweichen. |
Architektur im Überblick
Das Grundprinzip von pg_auto_failover: Ein Monitor führt regelmäßige Health-Checks gegen Primary und Secondary durch. Die Anwendung (hier: Keycloak) spricht per SQL primär mit dem Primary, kann bei Bedarf aber auch auf den Secondary ausweichen. Die Daten wandern per Streaming-Replikation vom Primary zum Secondary.
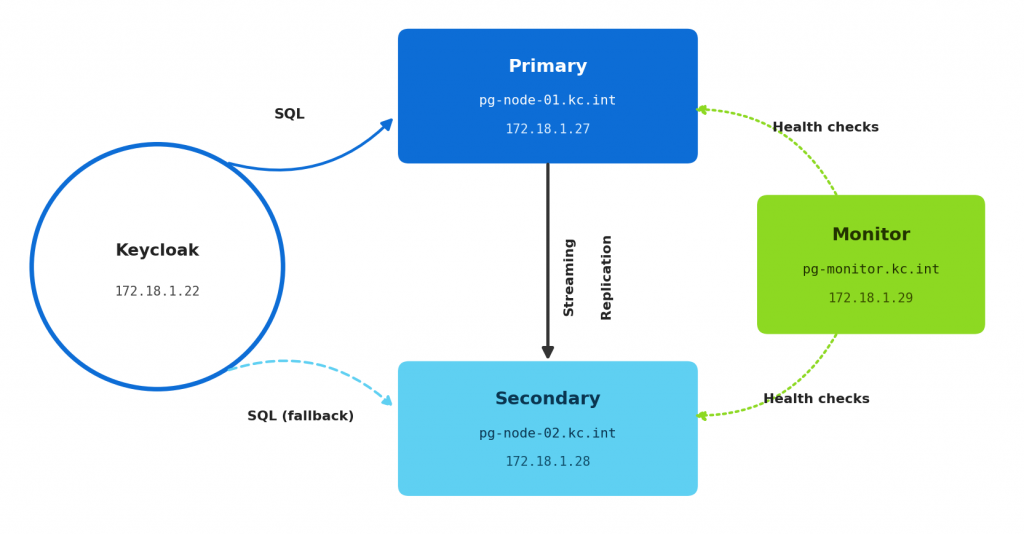
Für das Setup brauchst du vier Systeme (alle auf Ubuntu):
- PostgreSQL Instanz 1 – Primary
- PostgreSQL Instanz 2 – Secondary
- pg_auto_failover-Server – Monitor
- Keycloak-Instanz – Application
Fahrplan für den praktischen Teil
Im Praxisteil bauen wir Schritt für Schritt eine hochverfügbare PostgreSQL-Umgebung auf und lernen die wichtigsten Betriebsprozesse kennen.
- PostgreSQL-Grundkonfiguration optimieren
- Monitoring für System und Datenbank einrichten
- Primary-Datenbankserver konfigurieren
- Secondary-Datenbankserver anbinden
- Switchover- und Failover-Prozesse verstehen und testen
- Anwendungen über Connection Strings anbinden und Keycloak integrieren
Vorbereitung: PostgreSQL-Paket anpassen
Ubuntu legt bei der Installation von PostgreSQL standardmäßig automatisch einen lokalen Default-Cluster an – das willst du hier nicht, weil pg_autoctl die Instanzen selbst anlegen und verwalten soll. Erstelle bzw. erweitere dafür auf allen beteiligten Hosts die Datei /etc/postgresql-common/createcluster.conf und setze:
create_main_cluster = falseDanach installierst du PostgreSQL (aktuell empfohlen: Version 18 oder neuer) sowie das pg_auto_failover-CLI:
# PostgreSQL ohne Default-Cluster installieren
sudo apt install --no-install-recommends postgresql-18

# pg_auto_failover CLI installieren
sudo apt install pg-auto-failover-cli
Monitor einrichten
Auf dem Monitor-Host installierst du zusätzlich:
sudo apt-get install postgresql-18-auto-failoverDanach die Verzeichnisstruktur anlegen:
sudo mkdir /var/lib/pgmonitor
sudo chown postgres:postgres /var/lib/pgmonitor/
sudo rm -rf /tmp/pg_autoctl/
Der Monitor darf nicht als root laufen, sondern nutzt den vorhandenen postgres-Systemuser:
sudo su - postgres
pg_autoctl create monitor --pgdata /var/lib/pgmonitor \
  --auth scram-sha-256 --ssl-self-signed \
  --hostname pg-monitor.kc.int
Der Befehl legt die Monitor-Datenbank an, die später Status, Rollen und Failover-Entscheidungen der Nodes verwaltet. --auth scram-sha-256 aktiviert passwortbasierte Authentifizierung, --ssl-self-signed verschlüsselte Verbindungen mit selbstsigniertem Zertifikat.
Wichtig: Der bei --hostname angegebene Name ist laut pg_auto_failover-Doku genau die Adresse, über die andere Knoten diesen Knoten erreichen. Löst er sich auf dem Host lokal (z. B. über einen entsprechenden Eintrag in /etc/hosts) auf 127.0.0.1 auf, ist er für alle anderen Knoten unbrauchbar – Loopback bedeutet immer nur „dieser Rechner selbst“. Prüfe in diesem Fall /etc/hosts und stelle sicher, dass der Hostname auf die reale, im Netz erreichbare IP-Adresse zeigt. |
Zugriff erlauben – in /var/lib/pgmonitor/pg_hba.conf:
hostssl "pg_autofailover" "autoctl_node" 172.18.1.0/24 scram-sha-256Damit dürfen nur Clients aus 172.18.1.0/24 sich als autoctl_node per SSL und Passwort verbinden.
Monitor als Systemd-Service starten (dafür zurück zum eigenen Nutzer wechseln, postgres hat keine Admin-Rechte):
exit
export PGDATA=/var/lib/pgmonitor
pg_autoctl -q show systemd --pgdata "/var/lib/pgmonitor" | sudo tee /etc/systemd/system/pgautofailover.service

sudo systemctl daemon-reload
sudo systemctl enable pgautofailover.service
sudo systemctl start pgautofailover.service
Passwort für den Standardbenutzer setzen:
sudo su - postgres
psql postgres://127.0.0.1/pg_auto_failover

# sql
alter user autoctl_node password '<passwort>';
Trage das Passwort in /var/lib/postgresql/.pgpass ein:
#hostname:port:database:username:password
pg-monitor.kc.int:5432:*:autoctl_node:<passwort>
Und schütze die Datei:
sudo chown postgres:postgres /var/lib/postgresql/.pgpass
sudo chmod 600 /var/lib/postgresql/.pgpass
Die Parameter für die weiteren Instanzen findest du bei Bedarf mit:
pg_autoctl show uri --pgdata /var/lib/pgmonitor
pg_autoctl config get --pgdata /var/lib/pgmonitor
Primary einrichten
Zunächst wieder das Monitor-Passwort in /var/lib/postgresql/.pgpass hinterlegen (analog zu oben, mit pg_auto_failover als Datenbankname) und die Datei mit chown postgres:postgres / chmod 600 schützen.
Verzeichnisse anlegen – wichtig: Das Datenverzeichnis muss vom verwendeten Benutzer vollständig löschbar sein, sonst schlägt später die Secondary-Erstellung fehl:
sudo mkdir /var/lib/postgresql/pgnode
sudo chown postgres:postgres /var/lib/postgresql/pgnode/
sudo mkdir /var/lib/backup
sudo chown postgres:postgres /var/lib/backup/
sudo rm -rf /tmp/pg_autoctl/
Node erstellen (wieder als postgres-User):
sudo su - postgres
pg_autoctl create postgres --pgdata /var/lib/postgresql/pgnode \
  --auth scram-sha-256 --ssl-self-signed \
  --hostname pg-node-01.kc.int \
  --monitor 'postgres://autoctl_node@pg-monitor.kc.int:5432/pg_auto_failover?sslmode=require' \
  --username postgres --dbname appdb
Das erstellt die PostgreSQL-Instanz im Datenverzeichnis, registriert sie beim Monitor und legt gleich den initialen Benutzer (postgres) und die initiale Datenbank (appdb) an. Auch hier gilt: --hostname muss auf die reale IP-Adresse des Hosts auflösen, nicht auf 127.0.0.1 (siehe Hinweis oben).
Was ist appdb? Keine Keycloak-Datenbank und kein besonderer „Verwaltungscontainer“ – einfach eine mitgelieferte Anfangs-Datenbank, die pg_autoctl beim Erstellen der Instanz braucht, weil irgendein --dbname angegeben werden muss. Der Benutzer postgres (aus --username postgres) ist der ganz normale PostgreSQL-Superuser, den jede Postgres-Instanz sowieso automatisch anlegt – Rollen gelten in PostgreSQL immer cluster-weit, nicht „innerhalb“ einer bestimmten Datenbank. Wenn du später mit psql -U postgres die eigentliche Keycloak-Datenbank anlegst, nutzt du also denselben Superuser, unabhängig davon, mit welcher Datenbank du gerade verbunden bist. appdb selbst bleibt danach praktisch ungenutzt. |
Zugriff erlauben – in /var/lib/postgresql/pgnode/pg_hba.conf mindestens:
hostssl all "pgautofailover_monitor" 172.18.1.29/32 trust
hostssl "appdb" "postgres" 172.18.1.27/32 scram-sha-256
hostssl "appdb" "postgres" 172.18.1.28/32 scram-sha-256
hostssl replication "pgautofailover_replicator" 172.18.1.28/32 scram-sha-256
hostssl "appdb" "pgautofailover_replicator" 172.18.1.28/32 scram-sha-256
hostssl replication "pgautofailover_replicator" 172.18.1.27/32 scram-sha-256
hostssl "appdb" "pgautofailover_replicator" 172.18.1.27/32 scram-sha-256
Kurz erklärt: Der Monitor darf sich über pgautofailover_monitor verbinden, um den Zustand zu überwachen und Rollenwechsel zu steuern. Die appdb-Einträge erlauben Anwendungszugriffe, die replication-Einträge die Streaming-Replikation zwischen Primary und Secondary.
Hinweis zu trust: Bei der pgautofailover_monitor-Zeile fällt auf, dass dort trust statt scram-sha-256 steht – das bedeutet laut PostgreSQL-Doku, dass an dieser Stelle gar keine Authentifizierung stattfindet, sobald Verbindungstyp, Datenbank, Rolle und Absender-IP passen. Die offizielle pg_auto_failover-Security-Doku bezeichnet trust explizit als Muster für Testumgebungen, nicht als Produktionsempfehlung. Hier ist es nur deshalb vertretbar, weil die Zeile ohnehin auf eine einzelne IP (den Monitor, /32) und eine SSL-Verbindung beschränkt ist – die Absicherung passiert also über Netzwerksegmentierung, nicht über ein Credential. Übernimm trust nicht unreflektiert für andere Zeilen; für alles, was nicht exakt so eng eingegrenzt ist, gehört dort scram-sha-256 oder eine zertifikatsbasierte Authentifizierung hin. |
Als Systemd-Service starten:
exit
export PGDATA=/var/lib/postgresql/pgnode
export PG_AUTOCTL_MONITOR='postgres://autoctl_node@pg-monitor.kc.int:5432/pg_auto_failover?sslmode=require'
pg_autoctl -q show systemd --pgdata "/var/lib/postgresql/pgnode" | sudo tee /etc/systemd/system/pgautofailover.service

sudo systemctl daemon-reload
sudo systemctl enable pgautofailover.service
sudo systemctl start pgautofailover.service
Replikations-Passwort setzen (einmalig):
sudo su - postgres
psql postgres://127.0.0.1/appdb

#sql
alter user pgautofailover_replicator password '<passwort>';
Und für jeden Node in /var/lib/postgresql/.pgpass ergänzen:
echo "pg-node-01.kc.int:5432:*:pgautofailover_replicator:<passwort>" >> /var/lib/postgresql/.pgpass
echo "pg-node-02.kc.int:5432:*:pgautofailover_replicator:<passwort>" >> /var/lib/postgresql/.pgpass
Secondary einrichten
Die Secondary-Instanz installierst du identisch zum Primary – du passt lediglich den Hostnamen an und überspringst den Schritt zum Setzen des Replikations-Passworts (das ist bereits erledigt).
Switchover und Failover
Ein geplanter Switchover (z. B. für Wartungsarbeiten) lässt sich jederzeit manuell anstoßen:
sudo su - postgres
pg_autoctl perform switchover --pgdata "/var/lib/pgmonitor"
Der Monitor koordiniert dabei den kontrollierten Rollentausch, sodass der bisherige Secondary zum neuen Primary wird.
# interaktive Live-Ansicht
pg_autoctl watch

# Ausgabe:
Name Host:Port Reported State Assigned State
------ --------------------------- ---------------
node_1 pg-node-01.kc.int:5432 primary primary
node_2 pg-node-02.kc.int:5432 secondary secondary

Id Event Time Name Description
------ --------------------------- ---------------
612 2026-08-18 19:12:06 node_1 New state reported: "primary"
611 2026-08-18 19:12:06 node_2 Node marked as healthy by monitor
610 2026-08-18 19:12:06 node_1 Goal state set to "primary"
# aktueller Status
pg_autoctl show state
# Ausgabe:
Host | Rolle
-------------------------+----------
pg-node-01.kc.int:5432 | Primary
pg-node-02.kc.int:5432 | SecondaryAutomatisches Failover: Fällt ein Node aus, wartet der Monitor einen Timeout ab (um kurzfristige Netzwerkprobleme auszuschließen). War der ausgefallene Node der Primary, löst der Monitor danach automatisch ein Failover aus. Sobald der ausgefallene Node wieder verfügbar ist, werden die zwischenzeitlichen Änderungen nachrepliziert.
Während eines Failovers ist die Anwendung kurzzeitig nicht voll funktionsfähig, da die Primary-Verbindung wechseln muss – wie lange genau, hängt von der Anwendung ab. Fällt hingegen nur der Secondary aus, gibt es für die Anwendung keine Beeinträchtigung.
Ausfall aller Nodes
Fallen Primary und Secondary gleichzeitig aus, ist die Reihenfolge der Wiederinbetriebnahme entscheidend:
- Kommt der zuletzt ausgefallene Primary zuerst wieder hoch, sind keine weiteren Schritte nötig.
- Kommt stattdessen zuerst der zuletzt ausgefallene Secondary wieder hoch, ist der Cluster trotzdem nicht funktionsfähig – zwischen dem Ausfall des Secondary und dem späteren Ausfall des Primary können auf dem Primary noch Änderungen passiert sein, die dem Secondary fehlen. Prüfen lässt sich das über den LSN-Wert in
pg_autoctl show state.
Empfehlung: Wenn möglich immer zuerst den zuletzt ausgefallenen Primary wieder starten. Ist der Primary unwiederbringlich zerstört, kannst du den zuletzt ausgefallenen Secondary zum neuen Primary machen – dabei ist mit Datenverlust zu rechnen:
pg_autoctl perform failoverVerweigert pg_autoctl das Failover, muss der Cluster mit dem Secondary als Basis neu aufgebaut werden. Dazu zuerst den zerstörten Node entfernen:
pg_autoctl drop node --hostname pg-node-0X.kc.int --pgport 5432 --forceAnschließend einen neuen Secondary wie oben beschrieben aufsetzen.
(Ein Ausfall des Monitors selbst wird hier nicht behandelt.)
Konfiguration einsehen
Auf jedem Node lässt sich die aktuelle Konfiguration mit den passenden Umgebungsvariablen prüfen:
pg_autoctl config get

# Ausgabe:
[pg_autoctl]
role = monitor
hostname = pg-monitor.kc.int

[postgresql]
pgdata = /var/lib/pgmonitor
pg_ctl = /usr/lib/postgresql/18/bin/pg_ctl
username = autoctl_node
dbname = pg_auto_failover
host = /var/run/postgresql
port = 5432
listen_addresses = *
auth_method = scram-sha-256

[ssl]
sslmode = require
active = 1
cert_file = /var/lib/pgmonitor/server.crt
key_file = /var/lib/pgmonitor/server.key
Connection String für Anwendungen
Für die Anbindung an Anwendungen brauchst du den passenden Connection String (pro Anwendung mit eigener Datenbank statt appdb):
# Eingabe:
pg_autoctl show uri --formation default

# Ausgabe:
postgres://pg-node-01.kc.int:5432,pg-node-02.kc.int:5432/appdb?target_session_attrs=read-write&sslmode=require
Normalerweise erkennt eine Anwendung über target_session_attrs=read-write selbst, welcher Node gerade Primary ist. Keycloak (bzw. dessen JDBC-Treiber) möchte stattdessen targetServerType=primary sehen. Beide Parameter sorgen dafür, dass sich die Anwendung immer mit dem aktuell schreibfähigen Primary verbindet statt versehentlich mit einem Secondary.
Keycloak anbinden
Zuerst auf dem Primary Benutzer und Datenbank für die neue Keycloak-Instanz anlegen:
CREATE USER kcdbuser WITH PASSWORD '<passwort>';
CREATE DATABASE keycloakdb OWNER kcdbuser;
GRANT ALL PRIVILEGES ON DATABASE keycloakdb TO kcdbuser;
Und auf beiden Nodes in pg_hba.conf ergänzen:
hostssl "keycloakdb" "kcdbuser" 172.18.1.22/32 scram-sha-256Danach Keycloak mit dem passenden Connection String starten. Achte darauf, dass zusätzlich zum Datenbanknamen auch postgres:// zu postgresql:// wird:
sudo /home/administrator/keycloak-26.7.2/bin/kc.sh start \
  --http-host=0.0.0.0 --https-port=443 --http-enabled=false --http-port=8080 \
  --https-key-store-file=/opt/keycloak/certs/auth.kc.int.pfx --https-key-store-password='<passwort>' \
  --hostname=auth.kc.int \
  --db=postgres --db-url='jdbc:postgresql://pg-node-01.kc.int:5432,pg-node-02.kc.int:5432/keycloakdb?targetServerType=primary&sslmode=require' \
  --db-username=kcdbuser --db-password='<passwort>' \
  --bootstrap-admin-username=admin --bootstrap-admin-password='<passwort>' \
  --bootstrap-admin-client-id=admin --bootstrap-admin-client-secret='<passwort>'
Fazit
Mit pg_auto_failover bekommst du ein Active/Passive-Failover für PostgreSQL, das sich in überschaubarer Zeit aufsetzen lässt und ohne zusätzliche Infrastruktur wie einen externen Konsens-Store auskommt. Für Keycloak-Setups, bei denen ein Primary und ein Secondary ausreichen, deckt das die meisten Anforderungen gut ab. Wächst dein Bedarf – mehr Knoten, komplexere Topologien, feingranularere Steuerung – lohnt sich ein Blick auf Alternativen wie Patroni. Für den Einstieg und den Großteil der Praxisfälle ist pg_auto_failover aber ein sehr guter, pragmatischer Kompromiss aus Aufwand und Nutzen.